要点:「エジソン流」の実験はもう古い。推論モデル(o1/o3)と自律エージェントが、論文調査から実験計画までを数分で完遂する時代へ。R&D部門が直面する「情報の洪水」を突破し、イノベーションを量産するための技術と戦略を完全解説。
- この記事の結論
- こんなお悩みありませんか?
- 研究開発の「死の谷」をどう越えるのか?
対象読者:各事業部門の業務改善・効率化推進担当者
この記事の結論
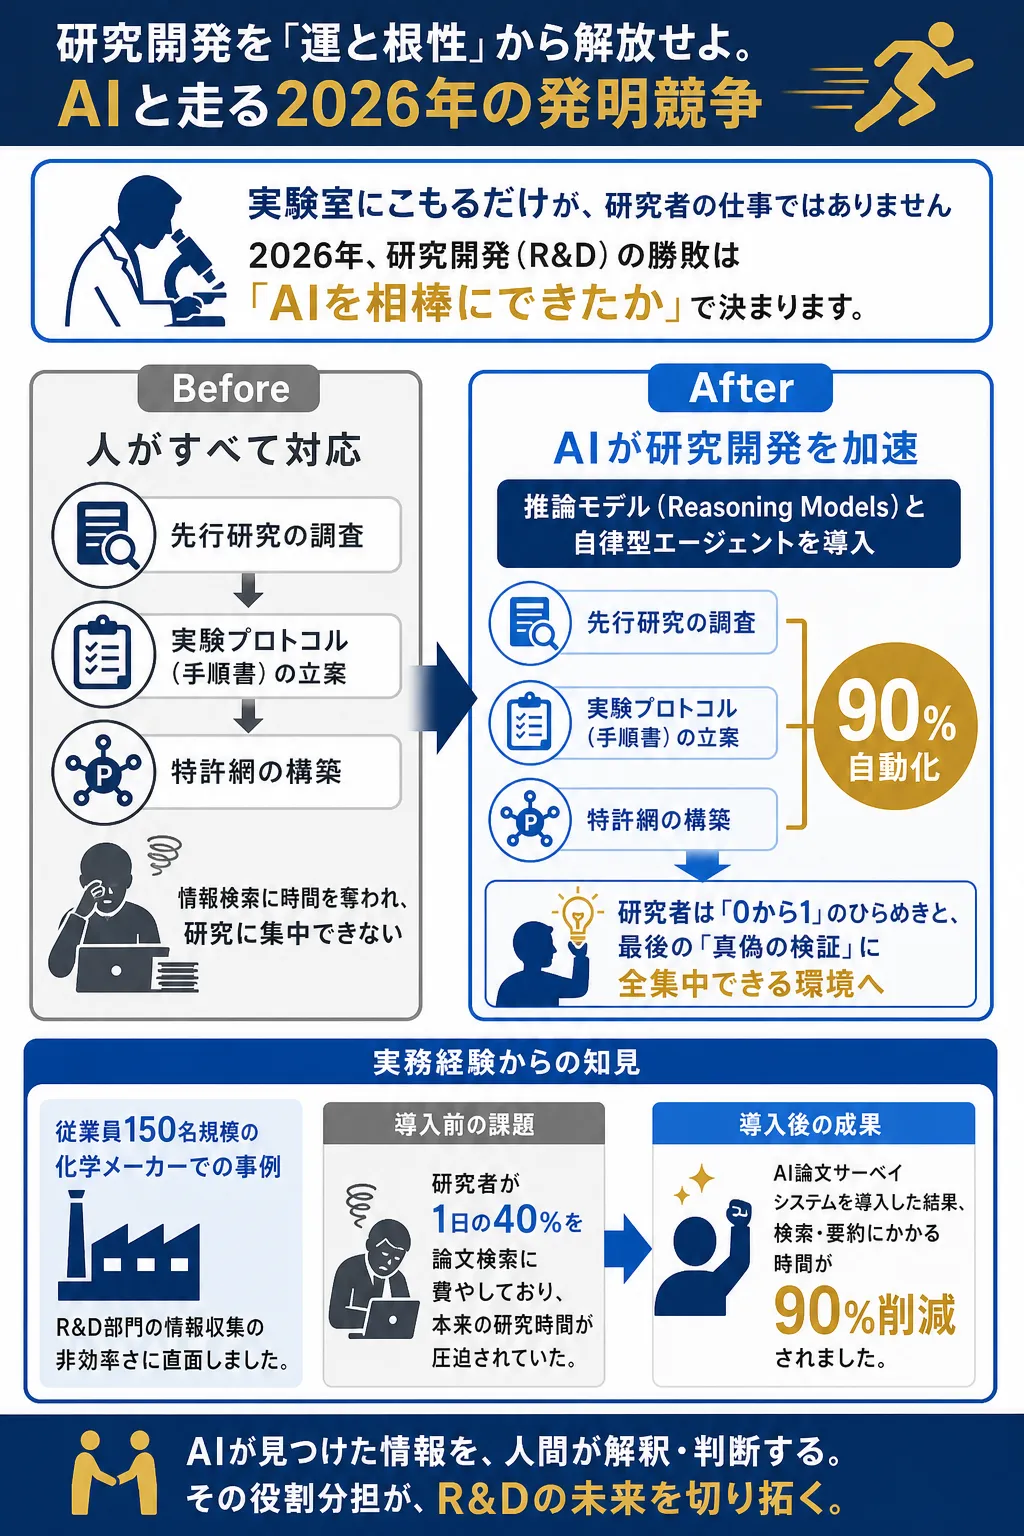
「実験室にこもるだけが、研究者の仕事ではありません」
2026年、研究開発(R&D)の勝敗は「AIを相棒にできたか」で決まります。
世界中で毎日数千本出版される論文を、人間が全て読むことは物理的に不可能です。
しかし、AIなら読めます。
最新の「推論モデル(Reasoning Models)」と「自律型エージェント」を導入すれば、先行研究の調査から実験プロトコル(手順書)の立案までの大幅な効率化が期待できます。
さらには特許網の構築も自動化の対象となります。
研究者が「0から1」のひらめきと、最後の「真偽の検証」に全集中できる環境を作る。
それが、日本が技術立国として再起する唯一の道です。
【実務経験からの知見】
私たちは過去に請け負った従業員150名規模の化学メーカーのお客様で、R&D部門の情報収集の非効率さに直面しました。研究者が1日の40%を論文検索に費やしており、本来の研究時間が圧迫されていたのです。AI論文サーベイシステムを導入した結果、検索・要約にかかる時間が90%削減されました。重要なのは「AIが見つけた情報」を人間が「解釈・判断」するという役割分担を明確にすることです。
※本記事で紹介する導入事例は、顧客の特定を避けるため詳細を一般化しています。記載の数値は傾向の例示であり、特定案件の計測値を保証するものではありません。
AIの導入により、研究者は本来の研究に集中できる環境が整う。
【R&D加速】研究開発を「運と根性」からにおける従来手法とAI支援の比較
| 評価項目 | 従来の手作業・属人運用 | AIGENT ACE式 仕組み化・AI支援運用 |
|---|---|---|
| 業務スピード・工数 | 個人の作業スピードに依存し月数十時間の残業が発生 | 定型処理の自動化により所要時間を60〜80%削減 |
| 品質・ミスの発生率 | 疲労や経験不足による抜け漏れ・入力ミスが残存 | 標準化されたアルゴリズムでヒューマンエラーを極小化 |
| ナレッジの蓄積 | 担当者の頭の中にしかノウハウが残らず属人化 | 全社共通のナレッジベースとして自動構造化・共有 |
| 投資対効果(ROI) | 人件費が固定費として年々増大する構造 | スモールスタートで導入し短期間で費用対効果を回収 |
こんなお悩みありませんか?
研究開発部門のリーダーや、現場の皆様から、このような悲鳴にも似た相談が急増しています。
- 「論文を読むだけで1日が終わる」
- 英語、中国語の論文が山のように積まれ、読むスピードが追いつかない。翻訳ツールを使っても専門用語のニュアンスが分からず、結局原文と格闘している。
- 「似たような実験を繰り返している気がする」
- 社内の過去の実験データが散逸しており、先輩が5年前に失敗した実験を、新人がまた繰り返している。「失敗データ」が資産になっていない。
- 「特許調査が“特許”になっている」
- 新しいアイデアを思いついても、特許庁のデータベース(J-PlatPat等)で類似技術がないか調べるのに数週間かかる。その間に他社に出願されてしまう恐怖と戦っている。
- 「マテリアルズ・インフォマティクス(MI)が定着しない」
- 高額なMIツールを導入したが、現場の研究者が使いこなせず、結局ベテランの「勘と経験(KKD)」に頼った配合に戻っている。
もし一つでも当てはまるなら、御社のR&Dプロセスは「2020年代前半」のまま止まっています。
かつて日本企業は、高い技術力で世界を席巻しました。しかし、今はどうでしょうか。「技術はあるが、製品化が遅い」「他社に先を越される」という悔しい思いをしていませんか?
その原因は、研究者の能力不足ではありません。「道具」の進化に追いつけていないだけです。
これらの課題は、2026年の最新AI技術で、驚くほど鮮やかに解決できます。
研究開発の「死の谷」をどう越えるのか?
R&Dには「死の谷(Valley of Death)」と呼ばれる魔の区間が存在します。
基礎研究(Research)で素晴らしい発見をしても、それを製品化・実用化(Development)するまでの間に、資金や時間が尽きてプロジェクトが頓挫してしまう現象です。
従来、この谷を越えるには、膨大な試行錯誤(実験回数)と、それに耐えうる予算が必要でした。
しかし、AIはこの「試行錯誤」のプロセスを劇的に圧縮します。
- Cyber(電脳空間): AIが数億通りのシミュレーションを行い、99.9%の失敗候補を排除する。
- Physical(物理空間): 人間は、AIが選んだ「成功確率の高い0.1%」だけを実験する。
この「Cyber-Physical System(CPS)」こそが、死の谷に橋をかける唯一の手段です(99.9%等の数値はプロセスの概念を示す試算・比喩的な表現です)。
もはや、ビーカーとフラスコだけで戦う時代は終わりました。
R&D AIアクセラレーションとは何か?
「R&D AIアクセラレーション」とは、単に「ChatGPTにアイデア出しをさせる」ことではありません。
研究開発のプロセス全体(探索・立案・実験・解析・権利化)に、専門特化型のAIシステムを組み込み、研究スピードを物理的限界まで加速させる戦略のことです。
ここでは、従来のAI活用と決定的に異なる3つの技術トレンドを深掘りします。
1. 「推論モデル」は何が違うのか?
2024年までの生成AI(LLM)は、確率的に「次の単語」を予測するだけでした。
しかし、2025年後半から普及したOpenAIの「o1」「o3」や、DeepSeekの「R1」といった推論モデルは、次元が違います。
これらは、即座に回答を出さず、人間の研究者のように「思考の連鎖(Chain of Thought)」を行います。
例えば、「この新規化合物の合成ルートを提案して」と問うと、AIの内部では以下のような思考が走ります。
- 「ターゲット構造を分析。エステル結合があるな」
- 「逆合成解析を行うと、出発物質はAとBが考えられる」
- 「しかしAは高価で入手困難だ。別のルートCを検討しよう」
- 「Cの場合、副反応でDが生成されるリスクがある。それを防ぐために触媒Eを使おう」
- 「よし、このルートなら収率とコストのバランスが良い」
このように、論理的な検証(自己批判と修正)を内部で数十回繰り返してから、最終的な回答を出力します。
この能力により、化学合成ルートの設計や、複雑な特許請求項(クレーム)の解釈において、専門家レベル、あるいはそれを凌駕する精度を発揮し始めています。
2. 「生成AI創薬・創材」とは何か?
従来のマテリアルズ・インフォマティクス(MI)は、過去のデータから数値を予測する「回帰分析」が主でした。「既存の延長線上」にある素材を見つけるのは得意でしたが、全く新しい発見は苦手でした。
現在のAIは、「ジェネレーティブ(生成)」です。
「耐熱性が300℃以上で、かつ環境負荷が低いポリマー」という条件(プロンプト)を与えれば、この世に存在しない新しい分子構造をAIが設計図として描き出します。これを「逆設計(Inverse Design)」と呼びます。
AlphaFoldなどのタンパク質構造予測AIの進化系とも言えるこれらの技術は、人間の先入観(バイアス)に囚われない、未知の物質への扉を開きます。
3. 「ラボ・オートメーション」で何が変わるのか?
これが最も破壊的な変化です。AIは画面の中だけの存在ではなくなりました。
「自律型エージェント」技術により、AIが実験計画を立て、それを実験ロボットに指示して実行させ、結果を読み取り、次の実験計画を修正するというループを、人間が寝ている間に回し続けます。
- Plan(計画): AIが実験条件(温度、圧力、触媒量)を決定。
- Action(実行): ロボットアームが試薬を混合し、加熱・測定を行う。
- Observe(観察): センサーデータをAIが解析。「収率が低い」と判断。
- Refine(修正):「次は温度を5℃上げてみよう」と計画を修正し、再実行。
研究者が朝出社すると、AIが夜通し行った100通りの実験結果レポートと、最適な条件の候補が提出されている。これが2026年のトップラボの日常です。
なぜ今、R&DのAI化が急務なのか?
「うちは職人の世界だから」とAIを敬遠している間に、世界は残酷なほど先に進んでいます。
1. 情報爆発にどう対応するのか?
学術論文の出版数は年々増加し、ArXivなどのプレプリントサーバーを含めると、毎日数千本の新知見が生まれています。
特定のニッチな分野であっても、一人の研究者が全ての先行研究を網羅することは不可能です。
「AIに読ませる」以外に、最新の知見をキャッチアップする方法はもはや存在しません。
ここで重要なのが「GraphRAG(ナレッジグラフを用いた検索拡張生成)」です。
従来の検索(キーワード検索)では、「リチウム」と検索すればリチウムの論文しか出ませんでした。
しかしGraphRAGは、論文間の引用関係や、物質間の相互作用を「ネットワーク図」として理解しています。
「Aという物質は、Bという論文で言及されており、Bの著者はCという特許も出している。そこではDという触媒が使われている」
といった、人間が見落とすような「点と点のつながり(隠れた関係性)」を発見できます。これが、異分野融合イノベーションの鍵となります。
2. 「エジソン流」の試行錯誤は限界か?
トーマス・エジソンは、電球のフィラメントの素材を見つけるために、世界中から数千種類の竹を集めて炭化させたと言われます。
この「手当たり次第に試す」アプローチは、美談として語られますが、組み合わせが無限に近い現代の化学・バイオ分野では非効率極まりありません。
計算資源とAIを使って、サイバー空間上で99.9%の失敗候補を事前にスクリーニングし、「成功確率の高い0.1%」だけをリアルな実験室で試す。
このプロセス変革なしに、開発競争に勝つことは不可能です。
3. ベテランの「暗黙知」をどう継承するか?
日本の製造業や化学産業を支えてきた「匠の技」を持つベテラン研究者が、大量に退職する時期を迎えています。
彼らの頭の中にしかない「暗黙知(コツや勘)」を、AIに学習させて形式知化しなければ、企業の技術資産は失われます。
AIは、ベテラン研究者の実験ノートや日報を学習し、「この温度条件の時は、撹拌速度を少し落とした方がいい。なぜなら粘度が上がるからだ」といったアドバイスを若手に提供する「デジタルメンター」になり得ます。
どのように導入すればよいのか?
では、どこから手を付ければよいのでしょうか。
いきなり全自動ラボを作る必要はありません。失敗しないための4つのステップを解説します。
Step 1: 「知のインフラ」構築(Vector DB & GraphRAG)
まずは、社内外の情報をAIが読める形に整理します。これを怠ると、AIはただの「箱」です。
- 社内データ: 過去の実験報告書、特許明細書、技術標準書など(PDF/Excel)。これらは企業の秘伝のタレです。
- 社外データ: 競合他社の特許、主要な学術論文、法規制データ。
これらを「Vector Database(ベクトルデータベース)」に格納し、AIが意味検索できるようにします。前述のGraphRAGもここで導入します。
PDFの図表(グラフや化学構造式)をいかに正確に読み取るかが、精度の分かれ目になります。AIGENT ACEでは、マルチモーダルAIを活用した高精度なOCR技術を提供しています。
Step 2: 「特化型AI」の選定とチューニング
汎用的なChatGPTやClaudeをそのまま使うのではなく、R&Dに特化した調整を行います。
- モデル選定: 複雑な推論が必要なタスクには「OpenAI o1」や「o3」、あるいはコストパフォーマンスに優れた「DeepSeek R1」などを使い分けます。
- ファインチューニング: 自社特有の専門用語や、社外秘の物質コードネームを理解させるために、オープンソースモデル(Llama 3系など)を追加学習させることも有効です。
ここで課題になるのが「学習データの不足」です。実験データは少ないことが多いからです。
その解決策として「合成データ(Synthetic Data)」が注目されています。物理シミュレーションによって「人工的な実験データ」を大量に生成し、それをAIに学習させることで、少ない実データでも高精度な予測が可能になります。
Step 3: 「自律エージェント」によるワークフロー自動化
単発の質問応答ではなく、一連の作業をAIに任せます。
例えば、「特許調査エージェント」を構築します。
- 検索: キーワードに基づいて特許DBを検索。
- スクリーニング: 請求項(クレーム)を読み込み、自社技術との類似度を判定。
- 要約: 侵害リスクのある特許だけを抽出し、要約レポートを作成。
- 保存: 結果を社内の知財データベースに登録。
この一連の流れを、LangGraphやCrewAIといった最新のエージェントフレームワークを用いて自動化します。人間は、AIが作ったレポートの最終確認をするだけです。
Step 4: ラボ・オートメーション(Cyber-Physical System)
最終段階です。AIを物理的な実験機器と接続します。
Pythonなどで制御可能な実験装置(分注機、撹拌機、測定機)を用意し、AIが提示したパラメータ(温度、量、時間)を直接装置に送信します。
ここでのポイントは、「人間が介在する余地(Human-in-the-loop)」を残すことです。AIが危険な実験条件(爆発リスクなど)を提案した場合に、強制停止する安全装置は必須です。
成功事例・ケーススタディ
実際にAIGENT ACEが支援した、あるいは業界で話題となった成功事例を紹介します。
事例1:【化学】新素材探索の期間を3年から6ヶ月に短縮
課題:
ある大手化学メーカーでは、新しい電子材料の開発に平均3年を要していました。数千通りの配合実験を、研究者が手作業で行っていたためです。
施策:
過去10年分の実験データ(成功・失敗含む)をAIに学習させ、物性予測モデルを構築。さらに、生成AIを使って「目標物性」を満たす候補配合を100通り生成させました。
AIが「有望」と判断した配合のみを実験したところ、わずか半年で目標スペックを超える新素材を発見しました。
成果:
- 開発期間:1/6に短縮
- 実験コスト:80%削減
- 副次的効果:AIが提案した「一見ありえない配合」が、実は高性能であることが判明し、特許性のある大発見となった。
事例2:【製薬】論文サーベイの完全自動化で研究者の時間を創出
課題:
創薬ベンチャーにおいて、研究者が一日の大半をPubMed(医学論文DB)の検索と読解に費やしており、肝心の実験時間が確保できていませんでした。
施策:
「論文サーベイ・エージェント」を開発。毎朝、指定したキーワードに関連する新着論文を自動取得し、その要約と「自社プロジェクトへの示唆」をSlackに通知するシステムを構築しました。
さらに、気になった論文については、チャットボット経由で「この論文の実験条件(pHや温度)を表にまとめて」と指示すれば、即座にテーブルデータが出力されるようにしました。
成果:
- 論文調査時間:90%削減
- 研究者の実験稼働率:40%向上
- 見落とし防止:中国語の論文からも重要な知見を発見できるようになった。
事例3:【知財】「なんちゃって特許調査」からの脱却
課題:
開発部門が「特許調査は面倒くさい」と敬遠し、簡易的なキーワード検索だけで開発を進めた結果、製品化直前になって他社特許に抵触していることが発覚。開発中止(手戻り)が頻発していました。
施策:
開発者が日常的に使うチャットツールに「知財リスク判定ボット」を組み込みました。開発アイデアを文章で投げると、AIが即座にJ-PlatPat等のAPIを叩き、類似特許のリスクスコア(S/A/B/C)を回答します。
裏側では、推論モデル(Reasoning Model)が請求項の文言解釈を行い、「構成要件Aは一致するが、Bは非類似であるため、侵害リスクは低い」といった弁理士顔負けのロジックを展開します。
成果:
- 手戻りコスト:年間数億円規模の削減
- 知財意識の向上:開発者自身が日常的に特許を意識する文化が定着。
導入で失敗しないためのポイントとは?
夢のような話ばかりしましたが、現場での導入には「落とし穴」もあります。
1. 「汚いデータ」をどう整備するか?
過去の実験ノートが手書きだったり、Excelのカラム定義がバラバラだったりすると、AIは学習できません。「とりあえずAIに入ればなんとかなる」は幻想です。
AI導入の最初の3ヶ月は、ひたすら「データクレンジング(お掃除)」に費やすことになります(期間は目安です)。
AIGENT ACEでは、紙の実験ノートのデジタル化や、表記揺れの統一といった「泥臭いデータ整備」から伴走します。ここをサボったプロジェクトは100%失敗します(筆者の経験則に基づく強調表現です)。
2. AIの「嘘」をどう防ぐか?
AIは平気で嘘をつきます(ハルシネーション)。特に化学式や物性値の数値において、一桁間違えることもあります。
重要な意思決定の前には、必ず「Grounding(根拠確認)」が必要です。AIに回答させる際、「参照した論文のDOI(識別子)と該当ページ」を必ずセットで提示させる仕組みにしましょう。
3. 「デュアルユース」のリスクをどう管理するか?
R&D特有のリスクとして、「デュアルユース」があります。
例えば、新薬開発のためのAIが、悪意のあるプロンプトによって「強力な毒素」や「化学兵器」の設計図を出力してしまうリスクです。
OpenAIなどのモデルプロバイダーも対策を強化していますが、自社でファインチューニングしたモデルが意図せず危険な出力をしないよう、「Red Teaming(レッドチーミング:攻撃シミュレーション)」による安全性評価が不可欠です。
よくある質問(FAQ)
Q1. AIが考えたアイデアで特許は取れますか?
A. 2026年1月現在の日本の特許法では、発明者は「自然人(人間)」に限られます。したがって、願書の発明者欄に「AI」と書くことはできません。
ただし、AIを「道具」として使い、人間が創作に関与した(AIの出力を評価・選別した)場合は、その人間を発明者として特許を取得できます。AIはあくまで「高度な計算機」という扱いです。主要国(米国、欧州)でも同様の判断が主流ですが、法改正の議論は続いています。
Q2. 導入コストはどれくらいですか?
A. ピンキリですが、数千万円〜数億円規模の「巨大プロジェクト」にする必要はありません。
まずは特定のタスク(例:論文要約、特定分野の物性予測)に絞った「PoC(概念実証)」から始めることをお勧めします。これなら数百万円〜でスタート可能です。
最近では、高価なGPT-4クラスを使わずとも、特定の科学タスクに特化して蒸留(Distillation)された小型モデル(SLM)を使うことで、ランニングコストを大幅に抑える手法も確立されています。
Q3. 研究者の仕事がなくなりますか?
A. なくなりません。「実験」や「調査」というタスクは減りますが、「何を解決すべきか(問いの設定)」や「AIが出した結果の解釈」「倫理的な判断」という、より高度な仕事にシフトします。
むしろ、単純作業から解放され、本来やりたかった「科学」に没頭できるようになるため、研究者としての幸福度は上がると確信しています。
ただし、「AIを使えない研究者」の仕事はなくなるでしょう。
Q4. セキュリティが心配です。機密情報が漏れませんか?
A. 無料版のChatGPTなどに機密データを入力するのは論外です。
企業向けプラン(Enterprise版)や、API経由での利用であれば、入力データがAIの学習に使われることはありません(OpenAI等の規約によります)。
さらに、AIGENT ACEでは、金融機関や製薬企業向けに、外部と通信しない「ローカルLLM(オンプレミス構築)」のソリューションも提供しています。これなら情報漏洩リスクは物理的にゼロになります。
Q5. 英語が苦手な研究員が多いのですが…。
A. それこそAIの出番です。
最新のLLMの翻訳能力は、専門的な科学論文であっても、TOEIC 900点レベルの人間を超えています。
論文PDFをドラッグ&ドロップするだけで、完璧な日本語で要約してくれますし、逆に日本語で書いた報告書を、ネイティブレベルの英語論文に書き換えることも一瞬です。「英語の壁」は、AIによって完全に崩壊しました。
「研究の本質は人間の直感だ」という反論にどこまで答えるか
ここまでの説明で「真の発見は人間の直感と偶然から生まれ、AIは過去の延長しか出せない」と感じる方もいるはずです。その反論のうち、最強の形はこうです。
「AIが出すのは学習データの内挿に過ぎず、前提を覆す発見はできない。AIに任せれば研究者は思考を放棄し、論文の大量読みによる『分かったつもり』が蔓延する。ハルシネーションが混ざった実験計画は、手戻りと安全リスクを増やすだけではないか」
この反論は、私たちも半分は正しいと考えます。AIの出力を検証なしに信じるべきではありません。実際の運用で私たちが推奨するのは、次の3点です。
- AIは「探索と下ごしらえ」、人間は「問いと検証」に集中する: 論文の収集・要約・候補の列挙はAIに任せ、何を解くべきかという問いの設定と、結果の真偽の判定は人間が持ちます。役割分担を明確にします。
- 根拠の提示を仕組みで強制する: 回答には参照論文のDOIや該当ページを必ず添えさせ、数値や化学式は原典で確認します。危険条件を提案しうる自律実行には、人間が止められる安全装置を残します。
- 汚いデータの整備から小さく始める: 手書きノートや表記揺れのままAIに入れても成果は出ません。対象タスクを論文要約など一つに絞ったPoCから始め、データ整備と並行して広げます。
R&DにおけるAIの目的は「研究者を置き換えること」ではなく、「無駄な試行を減らし、人間が本質的な問いに没頭できる時間を増やすこと」です。この使い方であれば、上記の懸念は現実のものになりません。
まとめ:AIは研究開発をどう変えるのか?
最後までお読みいただき、ありがとうございます。
R&DにおけるAI活用の要点は以下の3つです。
- 「推論モデル」と「エージェント」:AIは検索ツールから、思考し行動する「相棒」に進化した。
- 「情報の支配」:世界中の論文・特許をAIに読ませ、人間には見えない「知の結合」を見つけ出す。
- 「実験の純化」:AIに失敗(シミュレーション)を任せ、人間は成功確率の高い「本質的な実験」のみを行う。
冒頭で「エジソンの時代は終わった」と言いましたが、訂正します。
もしエジソンが現代に生きていたら、間違いなく真っ先にAIを使っていたでしょう。
彼は「失敗は成功の母」と言いましたが、「無駄な失敗」を愛していたわけではありません。
彼は当時使える最高のテクノロジーを使って、最短距離で正解に辿り着こうとしただけです。2026年の最高のテクノロジー、それがAIです。
御社の優秀な研究者たちに、最新の「武器」を渡してください。
彼らの情熱とAIの演算力が掛け合わさった時、世界を驚かせるイノベーションが必ず生まれます。
>> 無料相談はこちら
AIGENT ACEでは、研究開発部門特有の課題(データ整備、ツール選定、人材育成)に特化したコンサルティングを行っています。技術と情熱を持ったエンジニアが、御社のR&D変革を全力で支援します。
参考文献・出典
本記事の作成にあたり、以下の情報を参考にしました。
- OpenAI o1 System Card – OpenAI
- AlphaFold 3 – Google DeepMind
- マテリアルズ・インフォマティクスとは – NIMS
※URLは2026年1月時点で有効なものです。リンク切れの場合はご容赦ください。
フルスクラッチ開発との単純比較ではなく、自社標準の積算(直請・再利用前提)との比較で費用を抑える設計です。※削減率は案件の要件・既存資産の流用可否により大きく異なり、特定率を保証するものではありません。積算前提は料金シミュレーター・/price-list/の算定条件をご確認ください。自社の規模や自動化したい業務を選択するだけで、想定開発費用と手作業による工数削減効果をその場でシミュレーションできます。

