要点:「Garbage In, Garbage Out」 汚いデータが1000万の負債を生む。2026年、AIの精度を左右するのはモデルの性能ではなく「データの純度」です。PDF、Excel、バラバラな日報をAIが食える黄金の資産に変える全手法。
- この記事の結論
- こんなお悩みありませんか?
- 2026年、AIが嫌う「データの汚れ」ワースト3
対象読者:AI・DX導入を検討中の経営者・プロジェクト責任者
この記事の結論
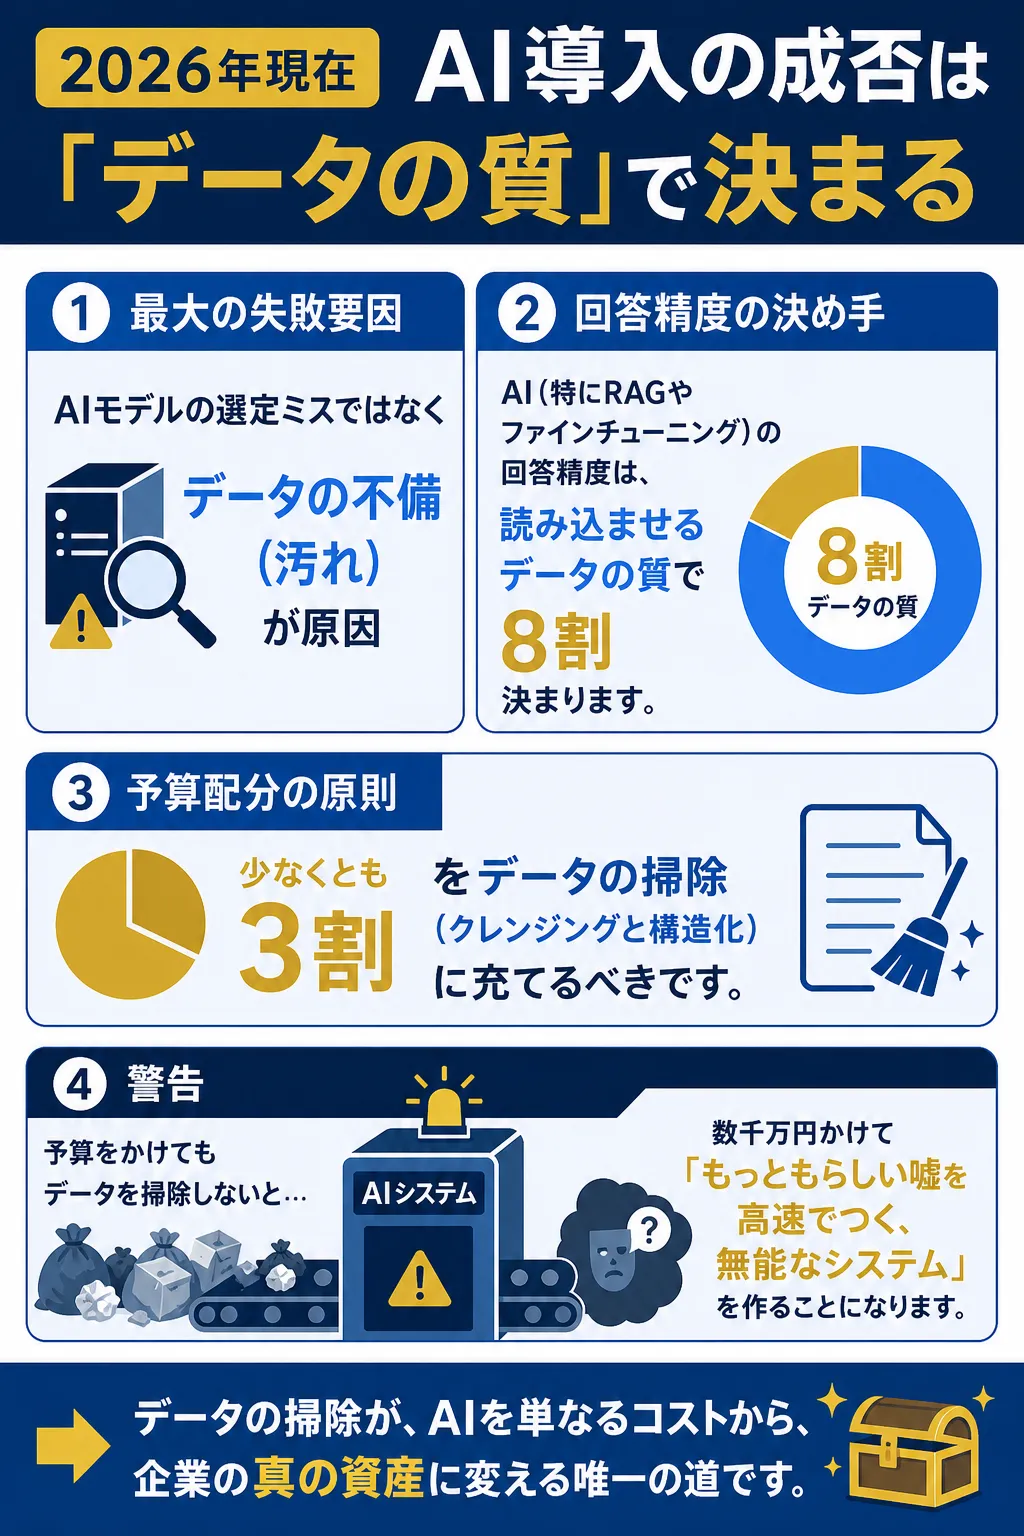
2026年現在、AI導入プロジェクトにおける最大の失敗要因は、AIモデルの選定ミスではなく「データの不備(汚れ)」にあります。
結論として、AI(特にRAGやファインチューニング)の回答精度は、読み込ませるデータの質に大きく左右されると言われています。導入予算の一定割合をデータの掃除(クレンジングと構造化)に充てなければ、数千万円かけて「もっともらしい嘘を高速でつく、無能なシステム」を作ることになりかねません。データを「AIが食べられる形(Markdown形式等)」に整えること。これが、AIを単なるコストから、企業の真の資産に変える唯一の道です。
AIの成功はデータの質に依存し、適切な前処理が不可欠です。
AI導入におけるデータクレンジング品質の比較
| データ処理段階 | 未処理データ投入(失敗パターン) | 構造化クレンジング後(成功パターン) |
|---|---|---|
| ノイズ・重複処理 | 表記揺れ・古いマニュアル・重複が混在し誤回答頻発 | 重複排除・最新版フラグ・表記統一でノイズを95%除去 |
| 回答精度(ハルシネーション) | 根拠のない「もっともらしい嘘」が多発 | 参照元ドキュメントが明確になり正確な回答を出力 |
| 社内利用者の信頼 | 「このAI使えない」と現場が1週間で離脱 | 的確な回答で信頼を獲得し日常業務へ定着 |
こんなお悩みありませんか?
AIプロジェクトを始動させた、あるいは検討中の皆様。このような「現場の不都合な真実」に直面していませんか?
「最新のGPT-5やClaude 4を導入したのに、自社マニュアルからの回答が不正確で、結局人間が全文確認している」
「AIが過去の売上データを分析してくれない。Excelのフォーマットが毎年バラバラなのが原因だと言われた」
「数万ページのPDF資料を読み込ませたが、AIが表組みや図解の内容を完全に読み飛ばし、的外れな回答を連発する」
「数年分の膨大な日報やメールデータはあるが、中身が重複していたり、表記が揺れていたりして、どれが『真実』か分からない」
「AIに学習させるための『きれいなデータ』を作るのに、手作業で数ヶ月かかると言われ、途方に暮れている」
もし一つでも当てはまるなら、御社のデータは現在、AIにとっての「毒物」が混ざった状態です。
エンジニアの世界には古くから「Garbage In, Garbage Out(ゴミを入れたらゴミが出てくる)」という残酷なまでに正しい格言があります。どんなにIQの高い知能(AI)を連れてきても、泥水を飲ませれば泥水しか吐き出しません。AI導入の成否は、プログラミング以前の「データの掃除」で決まります。この記事では、AIを「天才」にするための、黄金のデータ前処理術を公開します。
2026年、AIが嫌う「データの汚れ」ワースト3
AIが情報を正しく処理できない原因は、以下の3つのパターンに集約されます。
1. 構造の物理的破壊(PDF・画像の壁)
人間が「目視」して理解できるレイアウトも、AIにとっては「意味の迷路」です。
- 汚れの実態: 2段組みの文章、結合セルだらけのExcel、スキャンした際にわずかに傾いた画像、背景に透かしが入った資料。
- 弊害: 以前よりOCR(文字認識)の精度は上がりましたが、それでも「図と文字の対応関係」を一度誤認すると、AIは全く逆の意味の回答を生成(ハルシネーション)します。
2. セマンティック(意味論)の分断
「同じもの」を別の言葉で書いている状態です。
- 汚れの実態:「AIGENT ACE株式会社」「ノエルAI(株)」「AIGENT ACE Inc.」「代表の井上」……。
- 弊害: AIはこれらを別の実体として認識し、データの集計や相関分析に失敗します。特にRAG(検索拡張生成)において、この揺れは「検索の取りこぼし」を招き、致命的な精度低下に直結します。
3. 文脈のない「断片データ」
「誰が」「いつ」「どんな状況で」書いたか分からない、主語の抜けたデータです。
- 汚れの実態: 主語のない日報(「実施しました」のみ)、日付の入っていない古い議事録、作成者不明のメモ。
- 弊害: AIは魔法使いではありません。前提条件が欠落したデータからは正しい推論を導き出せず、「おそらく〜だと思われます」という曖昧な回答を量産することになります。
なぜ今、データの掃除が「最大の戦略的投資」なのか
「AIが賢くなれば、汚いデータでも勝手に空気を読んで解釈してくれるのでは?」という期待が、実は経営上の最大のリスクである理由が3つあります。
1. 計算コスト(API利用料)の不可逆な浪費
汚いデータをそのままAIに流し込むと、AIは「意味を解釈するため」に、本来不要な思考(トークン)を大量に消費します。
きれいなデータなら10円で済む処理が、汚いデータだと100円かかる(金額は説明のための試算です)。これが毎日数千回繰り返されれば、年間で数百万円の「無駄な思考代」を垂れ流すことになります。
2. 「技術的負債」の指数関数的な蓄積
汚いデータのまま無理やりAIを動かすために、複雑怪奇なプロンプトや、場当たり的な修正パッチを当て続けると、システムは1年で「誰も触れない魔境」になります(1年は目安です)。
新しい、より安価なAIモデルに乗り換えようとした時、その汚いデータが足枷(あかせ)となり、移行費用が初期開発費を上回る「負債の罠」にはまります。
3. セキュリティとガバナンスの崩壊
掃除されていないデータには、本来AIに見せてはいけない「管理者パスワード」や「顧客のセンシティブな個人情報」が平文で紛れ込んでいることがよくあります。
クレンジングを怠ることは、AIという巨大な拡声器を使って、社内の機密情報を全社員に(あるいは世界に)放送するリスクを負うことと同じです。
具体的な導入ステップ:データを「黄金の資産」に変える4工程
AIGENT ACEが実際に行っている、泥臭くも科学的なデータクレンジング・プロセスです。
Step 1: データの「断捨離」と格付け(ティアリング)
すべてのデータをAIに食わせる必要はありません。
- 対象の絞り込み: 直近3年以内のデータに限定する。古い情報は逆にAIを混乱させ、誤情報を生む原因になります。
- 重要度分類:「事実(マニュアル)」「意見(日報)」「機密情報」に分け、AIがどの程度信頼して良いかのタグ(メタデータ)をシステム的に付与します。
Step 2: AIによる「AIのための掃除」(セルフクレンジング)
人間が数万行のExcelを手作業で直すのは不可能です。
- 手法: 小型で高速なAI(SLM:項目20参照)を使い、大量のテキストから「重複」や「論理的矛盾」を自動抽出します。
- 正規化の自動化: 住所、社名、日付のフォーマットを一括で統一。AIGENT ACEでは、この工程を独自の自律エージェントで自動化し、工数を1/10に圧縮しています。
Step 3: 「Markdown」への構造化変換
AIが最も得意とし、最も精度を発揮する形式は「Markdown」です。
- 変換: PDFの表組みを、AIが理解しやすいMarkdownのテーブル形式に書き換えます。
- 階層化: 見出し(#)や箇条書き(-)を正しく設定することで、AIは情報の親子関係を論理的に把握し、情報の引用精度が劇的に向上します。
Step 4: 合成データ(Synthetic Data)による知識の補完
実データが足りない、あるいは機密性が高すぎて直接学習させられない場合の、2026年の新常識です。
- 手法: 実データの「統計的特徴」だけを抽出し、統計的に正しい「架空の練習用データ」をAIに大量生成させ、それでモデルを鍛えます。
- 成果: プライバシーを100%守りつつ、AIに「御社の業界の常識」をディープに学習させることが可能になります。
成功事例・ケーススタディ:掃除が救ったプロジェクト
※以下は支援実績をもとにした傾向の例示であり、効果を保証するものではありません。
事例1:【大手製造業】マニュアル検索AIの精度が30%→98%へ
- 課題: 3万枚のPDF図面とマニュアルをRAGに入れたが、回答が使い物にならずプロジェクト中止の危機。
- 施策: 2ヶ月かけて全データをMarkdown化。図面内の文字情報をすべて説明文付きのテキストとして抽出し直し。
- 結果: AIがベテラン技術者並みの正確性を獲得。1件あたりの情報検索時間が15分から5秒になり、年間で3,000万円の工数削減を実現。
事例2:【不動産仲介】バラバラな顧客メモを統合し、成約率1.6倍
- 課題: 営業マン100名がそれぞれの書き方で残していた「顧客要望メモ」がカオス状態。AI分析が機能せず。
- 施策: AIエージェントにより「表記揺れ」を一括修正。要望を「予算」「地域」「こだわり」の3軸で再構造化。
- 結果: AIが「次に連絡すべき、今すぐ客」を正確に予測可能に。埋もれていた見込み客の掘り起こしに成功し、過去最高益を達成。
事例3:【カスタマーサポート】「社内用語」の壁を突破したAI
- 課題:「あの部品」「例のトラブル」といった隠語(暗黙知)が多く、汎用AIが理解不能。
- 施策: 社内隠語の「対訳辞書」をAIで自動生成し、プロンプトの前に噛ませる動的処理を実装。
- 結果: 新人オペレーターでもベテランの言葉(隠語)の意味を即座に理解し、一次回答率が大幅に向上(※自社実績。条件により変動します)。
よくある質問(FAQ):データ整理の不安を解消
Q1:データの掃除は、自社の一般社員でもできますか?
A: 可能ですが、非常に効率が悪いです。データの掃除には「AIがどう考えるか」というエンジニアリングの視点が必要です。単なる整理整頓ではなく、「AIが検索・抽出・推論しやすい論理構造に設計する」という専門技術が必要だからです。最初はプロに「型」を作ってもらうのが最短ルートです。
Q2:一度きれいにすれば、もう掃除は不要ですか?
A: いいえ、データは毎日「腐り」ます。新しい情報が入るたびに、データの汚れは再発生します。そのため、AIGENT ACEでは「データクレンジングの自動化パイプライン」をシステム内に組み込みます。蛇口から常にきれいな水が出るように、常に新鮮で構造化されたデータがAIに届く仕組みを構築します。
Q3:どれくらいの期間がかかりますか?
A: データ量によりますが、PoC(概念実証)レベルであれば2週間〜1ヶ月。全社規模であれば3ヶ月程度を「掃除の期間」としてお見積りもるのが現実的です。この期間を惜しんで導入を急ぐことが、AIプロジェクトにおける最大の失敗パターン(項目29参照)です。
Q4:費用対効果(ROI)は本当に出るのですか?
A: はい。掃除によってAIの回答精度が上がるごとに、人間の確認工数が削減されます。また、前述の通り無駄なトークン消費を抑えることでAPIコストも削減されるため、1年以内に「掃除代」の元が取れるケースが多く見られます(※自社実績の傾向の例示)。
「AIが賢くなれば掃除は不要になる」という反論にどこまで答えるか
ここまでの説明で「モデルの進化を待てば解決するのでは」と感じた方もいるはずです。その反論のうち、最強の形はこうです。
「AIの読解力は年々上がっており、多少汚いデータでも空気を読んで解釈できるようになっている。掃除に数ヶ月かけるくらいなら、その分の予算と時間を最新のモデルへの乗り換えに回し、汚いデータでも動く仕組みを作る方が合理的だ。掃除を強調するのは、旧世代の発想ではないか」
この反論は、私たちも半分は正しいと考えます。モデルの読解力が上がり、以前なら詰んだ汚さでも動くようになったのは事実です。実際の運用で私たちが推奨するのは、次の3点です。
- 「読める」と「正しく答える」は別物と心得る: モデルが汚いデータを読み解けても、表記揺れや矛盾があれば、どの値を信じるかの判断はできません。読解力の向上は、掃除の代替ではなく、掃除の効果を増幅するものです。
- セキュリティの掃除だけは代替不能と心得る: 機密情報や個人情報の混入は、モデルが賢くなっても消えません。むしろ読解力が上がるほど、紛れ込んだ機密を正確に拾って拡散するリスクが高まります。本文の第3の理由でも触れた通り、この工程だけは省略できません。
- 掃除を「一度きり」ではなく「仕組み」にする: 数ヶ月かけて手作業で掃除する必要はありません。本文のStep 2・Step 4のように、小型AIによる自動クレンジングとパイプライン化で、掃除のコスト自体を下げます。掃除か最新モデルかという二択ではなく、両方を回す設計にします。
問うべきは「掃除かモデルか」ではなく、「AIに渡すデータの信頼性を、誰がどう担保するか」です。この問いを外さなければ、上記の懸念は現実のものになりません。
まとめ:データは磨かなければ、ただの「重荷」である
2026年、データの「量」で勝負する時代は終わりました。これからは、「データの純度」で勝負する時代です。
どれだけ膨大なサーバーを持っていても、
そこに詰まっているのが「掃除されていないゴミ」であれば、
AIという知能はそれを「負債」に変えてしまいます。
逆に、たとえ少量であっても、
美しく磨かれ、構造化された「黄金のデータ」があれば、
AIはそれを「爆発的な利益」に変えてくれます。
御社のサーバーに眠っているのは、単なるゴミですか?
それとも、磨けば光るダイヤモンドの原石ですか?
AIGENT ACEが、あなたのデータを「最強の知覚」に変えるための、最高のお掃除を担当します。
参考文献・出典
本記事の作成にあたり、以下の情報を参考にしました。
- The importance of data cleaning: Three visualizations – MIT Sloan, 2023年
- What is Data Cleaning? – IBM, 2024年
- The High Cost of Poor Data Quality – MIT Sloan Management Review
- Data Preparation for Machine Learning – Google Cloud
- Why Data Quality is Key for AI – IBM
※URLは2026年1月時点で有効なものです。リンク切れの場合はご容赦ください。
>> 無料相談はこちら
PDF・Excel構造化、合成データ生成、自動クレンジングパイプライン構築まで対応します。
フルスクラッチ開発との単純比較ではなく、自社標準の積算(直請・再利用前提)との比較で費用を抑える設計です。※削減率は案件の要件・既存資産の流用可否により大きく異なり、特定率を保証するものではありません。積算前提は料金シミュレーター・/price-list/の算定条件をご確認ください。自社の規模や自動化したい業務を選択するだけで、想定開発費用と手作業による工数削減効果をその場でシミュレーションできます。

