要点:ベンダーから納品されたAIシステム、本当に大丈夫ですか?2026年、回答の正確性、セキュリティ、コスト効率、そして保守性をプロの視点で客観的に評価するための網羅的なチェックリストを完全公開。
- この記事の結論
- こんなお悩みありませんか?
- AI品質管理とは?基本を解説:4つの柱
対象読者:ベンダー選定中の経営者・DX推進責任者
この記事の結論
2026年現在、AIシステムの納品(検収)において、従来のソフトウェアと同じ「ボタンを押して動くか」だけのテストは、もはや無意味です。結論として、AIの品質は「確率的な正しさをどう担保しているか」「予期せぬ入力にどう耐えるか」「運用コストが制御されているか」という3点を、客観的な数値で検品する必要があります。 この記事で紹介する40項目のチェックリストを使い、ベンダーが提出した「AIの回答」そのものではなく、その裏側にある「評価の仕組み(Eval)」と「設計の堅牢性」を厳しくチェックしてください。これが導入後の炎上を防ぎ、投資を無駄にしないための最も確実な防衛線です。
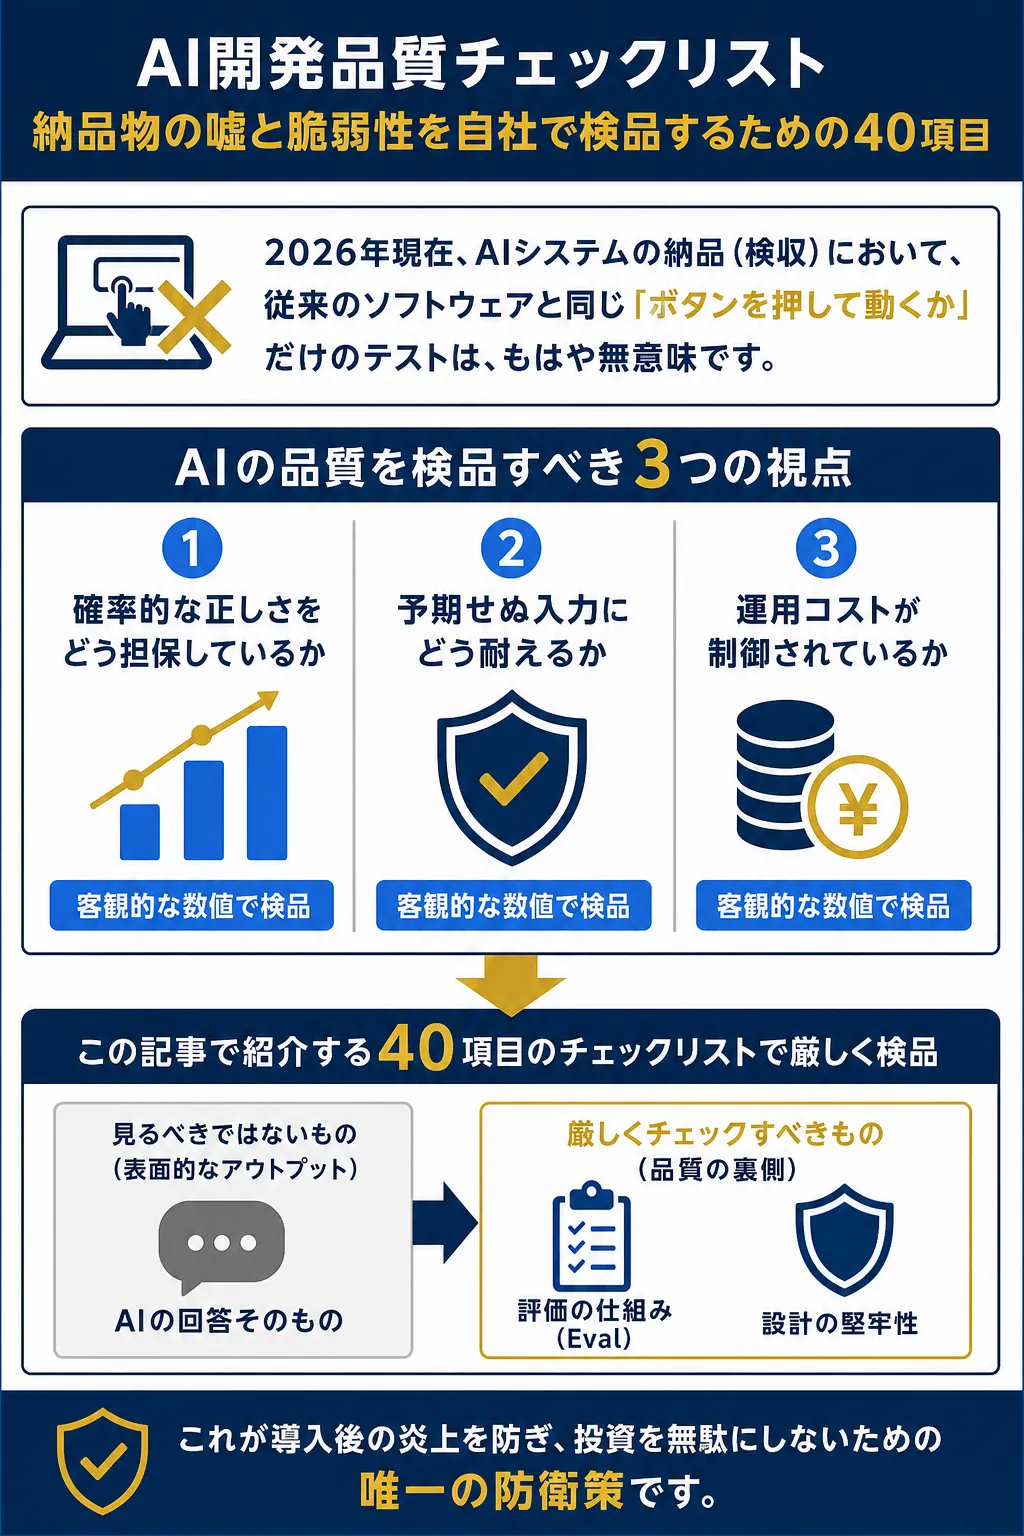
AIの品質を確保するためには、評価の仕組みと設計の堅牢性を厳しくチェックする必要があります。
こんなお悩みありませんか?
AIシステムの納品を控えた、あるいは運用を開始したばかりのプロジェクト責任者の皆様。このような「拭えない不安」を抱えていませんか?
「ベンダーは『精度が高い』と胸を張るが、こちらがいくつか意地悪な質問をすると、平気で嘘(ハルシネーション)をつく」
「検収時に何をチェックすれば『合格』と言えるのか、社内に統一された基準がなく、担当者の主観で決まってしまっている」
「使い始めたらAPIの請求額が予想を遥かに超えそうで、怖くて全社員に開放できずにいる」
「万が一、AIが不適切な回答をしたり機密情報を漏洩させたりした場合の、ベンダーとの責任分界点が曖昧なままだ」
「開発担当のエンジニアが辞めた後、この複雑なプロンプトやコードを誰もメンテナンスできないのではないか」
これらの不安は、AI特有の「不確実性」に対する評価基準が不明確であるために起きます。従来のITシステムは「1+1=2」の決定論的な世界でしたが、AIは「確率」の世界です。だからこそ、主観を排除した「科学的な検品」が必要なのです。この記事では、1,000万円以上のAI投資を「電子ゴミ」にしないための、40項目のチェックリストを公開します。
AI品質管理とは?基本を解説:4つの柱
2026年、AIの品質は単なる「正解率」だけでは測れません。以下の4つの観点を統合して評価します。
| 品質管理の柱 | 主な検品観点 | 合格基準の目安 | 放置した場合のリスク |
|---|---|---|---|
| 1. 精度と信頼性 | 自動評価(Eval)、ハルシネーション率、根拠提示 | Ragas等の機械採点指標達成、誤答率1%未満 | 誤情報による実務トラブル・現場の利用停止 |
| 2. セキュリティ・倫理 | プロンプトインジェクション耐性、PII秘匿化 | マスキング動作、プロバイダー再学習の遮断 | 機密・個人情報の外部流出、社会的信用失墜 |
| 3. コスト・効率 | トークン消費量管理、安価モデル自動ルーティング | 1リクエスト単価管理、予算枠内での制御 | 利用増に伴うAPI費用の暴走・機能制限 |
| 4. 保守性・持続性 | 疎結合アーキテクチャ、新モデル差し替え耐性 | 設定変更のみで上位モデルへの移行が可能 | モデル陳腐化による数千万円規模の再開発 |
1. 精度と信頼性(Accuracy & Reliability)
「10回中9回正解した」という結果だけを見るのではありません。
- Eval(評価)の仕組み: どのようなテストデータセットを用いるか。どのような指標で自動評価を行っているか(指標の例: Ragasスコア=AIの回答精度を機械的に採点するオープンソースの評価ツール)。この「プロセスの正しさ」を検品します。担当者の「触ってみた感触」は毎回ブレますが、同じデータセットで機械採点した数値は再現できます。この差が、信頼できる根拠になります。
2. セキュリティと倫理(Security & Ethics)
AIは、悪意のある入力によって内部情報を漏洩させる脆弱性を持っています(詳しくはAIセキュリティ|DLPと爆速活用の絶対両立手法を参照)。
- ガードレールの実装: プロンプトインジェクションへの対策や、不適切な差別表現を遮断するフィルター層が、システムレベルで多重に組み込まれているかを検品します。
3. コストと効率(Cost & Efficiency)
「動けばいい」という設計は、APIコストの暴走を招きます。導入前に想定コストを試算する方法はAI導入のROI計算完全マニュアルで解説しています。
- トークン管理: 不要な長文を読み込ませていないか、安価なモデルへの自動ルーティング(LLMルーティング)が機能しているかを検品します。
4. 保守性と持続性(Maintainability)
AI業界の3ヶ月は、従来の3年に匹敵します。
- 疎結合設計: モデルが新しくなった際(例:GPT-4からGPT-5へ)、コードを書き換えずに設定変更だけで対応できる「アセットグレード」な設計かを検品します。
なぜ今、独自のチェックリストが必要なのか
「プロのベンダーに任せているから大丈夫」という考え方が危険な理由が3つあります。
1. ベンダーの「体感評価」を疑うため
多くのベンダーは「開発者が触ってみて、良い感じだったので納品します」という、驚くほどアナログな基準で動いています。独自のチェックリストを突きつけることで、ベンダーに「自動評価レポート」の提出を義務付け、客観的な品質証明を求めることができます。
2. 「負の資産(技術的負債)」を抱えないため
汚いプロンプトや、特定のAPIに依存しきったコードは、納品された瞬間に「負債」となります。半年後のモデル更新時に、再度数千万円の改修費を請求されるような事態を防ぐには、検収段階で「将来の変更に耐えうる設計か」を弾く必要があります。
3. 企業の社会的信用(ガバナンス)を守るため
一度でもAIが顧客に対して致命的な嘘をついたり、社外秘を漏洩させれば、企業の信頼は失墜します。チェックリストは、単なる機能テストではなく、経営陣の「善管注意義務」を果たすための証跡になります。
AI開発品質チェックリスト:全40項目
納品物に対して、以下の項目を一つずつチェックしてください。
A. 回答品質・精度編(10項目)
- 1. 回答の根拠(ソース)となる社内ドキュメントの引用箇所が明示されているか?
- 2. 複数の異なるAIモデル(LLM-as-a-Judge)による自動評価スコアが基準値を超えているか?
- 3. データの欠落や矛盾に対して、AIが「分かりません」と正しく回答を拒否できるか?
- 4. 過去の文脈を考慮し、一貫性のある回答が維持されているか?
- 5. PDFの図表や複雑なレイアウトを、AIが誤解せずに構造化して認識できているか?
- 6. 専門用語や社内隠語に対する「対訳辞書(シソーラス)」が適用されているか?
- 7. ハルシネーション(嘘)の発生率が、事前定義された閾値(目安:1%以下)に収まっているか?
- 8. 質問の意図が曖昧な場合、AIが勝手に推測せず「聞き返し」を行っているか?
- 9. 長文の回答において、論理構成が破綻(自己矛盾)していないか?
- 10. 評価用データセット(Gold Dataset)が、現場の生々しい質問を反映しているか?
B. セキュリティ・ガバナンス編(10項目)
- 11. PII(個人情報)を検知し、AIに送る前に自動でマスキングする機能があるか?
- 12. プロンプトインジェクション(指示の書き換え攻撃)に対する多層防御が機能しているか?
- 13. 不適切、差別的、または公序良俗に反する出力のフィルタリング層があるか?
- 14. 全ての利用ログ(誰が、いつ、何を、いくらで)が、監査可能な状態で保存されているか?
- 15. APIキーがコード内にハードコードされず、適切なシークレット管理ツールで運用されているか?
- 16. データレジデンシー(データの保管場所)が、社内規定の国・地域に制限されているか?
- 17. AIの判断ミスが発生した際の「通報ボタン」と「人間へのエスカレーション」導線があるか?
- 18. 入力データが外部プロバイダーの再学習に利用されない設定が、システムレベルで固定されているか?
- 19. ログイン認証において、社内のSSO(シングルサインオン)と連携できているか?
- 20. 出力された情報の「著作権リスク」を自動で警告する仕組みはあるか?
C. アーキテクチャ・コスト最適化編(10項目)
- 21. APIゲートウェイ(LiteLLM等)を介しており、将来のモデル変更が数分で完了するか?(ゲートウェイを挟まず各モデル固有の呼び出し形式をコード内に直書きしていると、モデル変更のたびにその箇所を全て探して書き換える改修作業が発生します)
- 22. 質問の難易度に応じて安価なモデル(Flash/Haiku等)へ自動で振り分ける機能はあるか?
- 23. 同じ質問に対する「キャッシュ(再利用)」機能があり、無駄なAPI代を削っているか?
- 24. 1ユーザーあたりの利用上限(クォータ)を設定し、コストの暴走を防いでいるか?
- 25. サーバーレス構成を採用し、アイドル時の維持費が最小限に抑えられているか?
- 26. 同時アクセスが集中した際の「スロットリング(流量制限)」が設計されているか?
- 27. レスポンスの「最初の1文字」が出るまでの速度(TTFT)が2秒以内に収まっているか?
- 28. プロンプトの文字数が無駄に肥大化しておらず、トークン効率が最適化されているか?
- 29. ネットワーク障害時の「自動リトライ」および「フォールバック(代替手段)」があるか?
- 30. システム構成図が、2026年時点の最新のAIデザインパターン(MAS等)に基づいているか?
D. ドキュメント・保守運用編(10項目)
- 31. プロンプトの「意図」と「修正履歴」が、Git等のバージョン管理下に置かれているか?
- 32. 専門のエンジニアがいなくても、管理画面からプロンプトやRAGデータを更新できるか?
- 33. システムの死活監視だけでなく、AIの「回答精度の劣化」を監視する仕組み(漂流検知)があるか?
- 34. コードレビューにおいて、シニアエンジニアによる「AI特有の脆弱性」チェックが完了しているか?
- 35. 納品物に、将来の内製化を想定した「技術移転マニュアル」が含まれているか?
- 36. 使用されているOSS(オープンソース)のライセンスが、自社の利用形態と抵触していないか?
- 37. データバックアップと、障害からの復旧手順書(DR)が最新化されているか?
- 38. 開発環境、検証環境、本番環境が完全に分離され、CI/CDパイプラインが構築されているか?
- 39. 保守サポートのSLA(サービス品質保証)において、AIの誤動作への対応フローが明確か?
- 40. 「コードがそのまま設計図になっている(Code as Design)」状態が維持されているか?
具体的な導入ステップ:検収を「攻め」のイベントにする方法
AIGENT ACEが推奨する、ベンダーとの品質合意プロセスです。
Step 1: RPF(提案依頼)時にチェックリストを添付する
「この40項目をクリアすることが検収の条件です」と最初から伝えておくことで、ベンダーの手抜きを未然に防ぎ、最初から精度の高い提案を引き出します。
Step 2: 第3者による「コード・プロンプト診断」
自社に判断できるエンジニアがいないなら、AIGENT ACEのような外部のテックリードをセカンドオピニオンとして雇ってください。月に一度ソースをチェックされると分かっているだけで、ベンダー側は手を抜きにくくなり、検収時の手戻りが目に見えて減ります。
Step 3: 段階的な本番開放(カナリアリリース)
検収が終わっても、いきなり全社員に開放してはいけません。まずは一部のパワーユーザーで「実務での品質」を1週間テストし、そこで出た「失敗ログ」をAIにフィードバックする最後のチューニング期間を設けてください。
成功事例・ケーススタディ
※以下は、複数の支援実績で実際に見つかった課題パターンをもとに再構成した代表例です(個社を特定できる情報は含みません)。
事例1:チェックリストで「致命的な欠陥」を見抜いた企業
- Action: 納品直前にAIGENT ACEのチェックリストで点検。
- Result: 項目29(フォールバック)が欠落しており、OpenAIの障害時に全社業務が停止するリスクを発見。急遽、Googleモデルへの自動切り替えを実装させ、導入翌月のAPI障害を無傷で乗り越えた。
事例2:ガバナンス基準をクリアし、全社導入を加速
- Action: 項目11(PIIマスキング)と14(ログ監査)を徹底。
- Result: 最も保守的だった法務・コンプライアンス部門を「これなら安全だ」と納得させ、計画より半年前倒しで全社展開を実現。
よくある質問(FAQ)
Q1:40項目すべてをクリアするのは、コストがかかりすぎませんか?
A: 業務のリスクレベルに応じて「必須」と「推奨」を使い分けてください。社内向けの「便利ツール」であれば精度の優先度を下げても良いですが、顧客向けの「契約支援」であれば、セキュリティと精度項目は100%必須です。
Q2:ベンダーから「AIだから100%の品質は保証できない」と言われました。
A: それは正しいですが、「品質を管理する仕組み」は確実に保証できます。「必ず正解を出すこと」を求めるのではなく、「不正解を検知し、改善し続けるLLMOps(運用基盤)が納品されているか」を問うべきです。
Q3:他社で作ったシステムも診断してもらえますか?
A: はい、可能です。AIGENT ACEの「AI健康診断」プランでは、他社が作成したプロンプトやアーキテクチャをこの40項目に沿って精密検査し、改善点をレポートします。
「40項目も見ていたら納品が進まない」という反論にどこまで答えるか
ここまでの説明で「ここまで細かく見たら、ベンダーとの関係が壊れる」と感じる方もいるはずです。その反論のうち、最強の形はこうです。
「チェックリストは机上の理想論だ。40項目も突きつければ開発は遅れ、コストも膨らむ。良いベンダーを選んで信頼して任せる方が、結局は早くて安い。疑いの目で見る文化が、良いものづくりを殺すのではないか」
この反論は、私たちも半分は正しいと考えます。すべての項目を一律の必須にすべきではありません。実際の運用で私たちが推奨するのは、硬直化させないための次の3点です。
- リスクに応じて必須と推奨を使い分ける: 社内向けの便利ツールと顧客向けの契約支援では、求める厳しさが違います。守るべき項目に絞るからこそ、チェックが機能します。
- 提案依頼の時点で渡しておく: 検収の直前に突きつけるのではなく、最初から条件として共有します。後出しにしなければ、関係は壊れません。
- 第三者の目を早めに入れる: 自社で判断できない部分は、外部の技術者に早い段階で見てもらいます。手戻りが減るため、結果的に納期も守れます。
チェックリストの目的は、ベンダーを疑うことではなく、双方が合意できる品質の物差しを持つことです。この使い方であれば、上記の懸念は現実のものになりません。
まとめ:検収は「信頼」の最終確認である
AIは、優れた設計を施せば「最強の相棒」になりますが、ずさんな開発を放置すれば「最大の負債」になります。
「なんとなく良さそう」という担当者の主観に頼った評価から、40項目のチェックリストで数値と事実に基づいて検品する体制に切り替えること。それが、御社のAI投資を無駄にしないための最短ルートです。
AIGENT ACEは、この40項目に沿った検収代行・セカンドオピニオン提供を通じて、御社のAI導入を支援します。
参考文献・出典
本記事の作成にあたり、以下の情報を参考にしました。
- Ragas: Evaluation Framework for their RAG pipelines – Ragas
- Arize Phoenix: ML Observability for LLMs – Arize AI
- LiteLLM: Proxy to Call 100+ LLM APIs – LiteLLM / BerriAI
※URLは2026年1月時点で有効なものです。リンク切れの場合はご容赦ください。
>> 無料相談はこちら
AI開発品質の番人。AI品質診断、検収代行、セカンドオピニオン、LLMOps構築支援まで。
フルスクラッチ開発との単純比較ではなく、自社標準の積算(直請・再利用前提)との比較で費用を抑える設計です。※削減率は案件の要件・既存資産の流用可否により大きく異なり、特定率を保証するものではありません。積算前提は料金シミュレーター・/price-list/の算定条件をご確認ください。自社の規模や自動化したい業務を選択するだけで、想定開発費用と手作業による工数削減効果をその場でシミュレーションできます。

